Domain twhl.de kaufen?
Wir ziehen mit dem Projekt
twhl.de um.
Sind Sie am Kauf der Domain
twhl.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain twhl.de kaufen?
Was sind die beliebtesten Arten von Modding in der Gaming-Community?
Die beliebtesten Arten von Modding in der Gaming-Community sind Texturen- und Grafikmodifikationen, die das Aussehen des Spiels verbessern. Außerdem sind Gameplay-Mods beliebt, die neue Funktionen, Charaktere oder Missionen hinzufügen. Schließlich sind auch Total Conversion Mods beliebt, die das Spiel vollständig verändern und eine neue Spielerfahrung bieten. **
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **

Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Mapping Black EuropeMapping Black Europe , Monuments, Markers, Memories , Messgeräte & Anzeige > Innenausstattung , Erscheinungsjahr: 202303, Produktform: Kartoniert, Beilage: Kt, Titel der Reihe: Public History - Angewandte Geschichte#7#, Redaktion: Kelly, Natasha A.~Vassell, Olive, Seitenzahl/Blattzahl: 200, Abbildungen: 33 SW-Abbildungen, Themenüberschrift: HISTORY / Europe / General, Keyword: Afro-German; Afro-Italian; Black Amsterdam; Black Belgium; Black Berlin; Black British; Black Community; Black Culture; Black Europe; Black Germans; Black Italian; Black Knowledge; Black London; Black Paris; Black Rome; Black Warsaw; Blakc Copenhagen; Colonialism; Community Activism; Cultural History; European History; History; History of the 20th Century; Memorials; Memory Culture; Monuments; Plaques; Post-colonialism; Public Memory; Racism; Society; Statues; Urban History, Fachschema: Europa / Geschichte, Kulturgeschichte~Cultural Studies~Kulturwissenschaften~Wissenschaft / Kulturwissenschaften~Populärkultur~Trivialkultur, Fachkategorie: Europäische Geschichte~Sozial- und Kulturgeschichte~Geschichte allgemein und Weltgeschichte, Region: Europa, Thema: Auseinandersetzen, Warengruppe: HC/Geschichte/Allgemeines/Lexika, Fachkategorie: Populäre Kultur, Thema: Verstehen, Text Sprache: eng, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Transcript Verlag, Verlag: Transcript Verlag, Verlag: Gost, Roswitha, u. Karin Werner, Länge: 222, Breite: 144, Höhe: 13, Gewicht: 318, Produktform: Kartoniert, Genre: Geisteswissenschaften/Kunst/Musik, Genre: Geisteswissenschaften/Kunst/Musik, Alternatives Format EAN: 9783839454138, Herkunftsland: DEUTSCHLAND (DE), Katalog: Gesamtkatalog, Katalog: Internationale Lagertitel, Katalog: internationale Titel, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 238538324,19 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Bereichsspezifische Informationsextraktion für semantische Annotation, Taschenbuch von Zeeshan Ahmed, BoD - Books on Demand, 978-620-2-73428-8Bereichsspezifische Informationsextraktion Für Semantische Annotation, Taschenbuch Von Zeeshan Ahmed, Bod - Books On Demand, 978-620-2-73428-8, Seitenanzahl: 8426,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Modell zur Informationsextraktion für Afan Oromo Nachrichtentexte, Taschenbuch von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7Modell Zur Informationsextraktion Für Afan Oromo Nachrichtentexte, Taschenbuch Von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7, Seitenanzahl: 6849,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **

Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
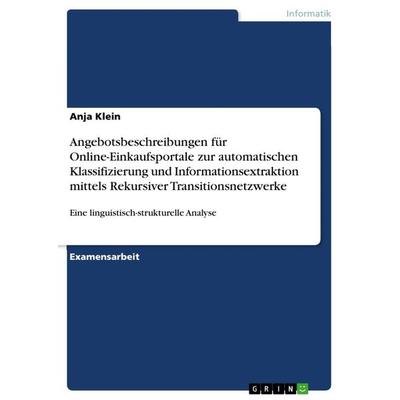
Angebotsbeschreibungen für Online-Einkaufsportale zur automatischen Klassifizierung und Informationsextraktion mittels RekursiverAngebotsbeschreibungen Für Online-einkaufsportale Zur Automatischen Klassifizierung Und Informationsextraktion Mittels Rekursiver Transitionsnetzwerke, Taschenbuch Von Anja Klein, Grin, 978-3-668-14793-5, Seitenanzahl: 6427,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Mapping Black EuropeMapping Black Europe , Monuments, Markers, Memories , Messgeräte & Anzeige > Innenausstattung , Erscheinungsjahr: 202303, Produktform: Kartoniert, Beilage: Kt, Titel der Reihe: Public History - Angewandte Geschichte#7#, Redaktion: Kelly, Natasha A.~Vassell, Olive, Seitenzahl/Blattzahl: 200, Abbildungen: 33 SW-Abbildungen, Themenüberschrift: HISTORY / Europe / General, Keyword: Afro-German; Afro-Italian; Black Amsterdam; Black Belgium; Black Berlin; Black British; Black Community; Black Culture; Black Europe; Black Germans; Black Italian; Black Knowledge; Black London; Black Paris; Black Rome; Black Warsaw; Blakc Copenhagen; Colonialism; Community Activism; Cultural History; European History; History; History of the 20th Century; Memorials; Memory Culture; Monuments; Plaques; Post-colonialism; Public Memory; Racism; Society; Statues; Urban History, Fachschema: Europa / Geschichte, Kulturgeschichte~Cultural Studies~Kulturwissenschaften~Wissenschaft / Kulturwissenschaften~Populärkultur~Trivialkultur, Fachkategorie: Europäische Geschichte~Sozial- und Kulturgeschichte~Geschichte allgemein und Weltgeschichte, Region: Europa, Thema: Auseinandersetzen, Warengruppe: HC/Geschichte/Allgemeines/Lexika, Fachkategorie: Populäre Kultur, Thema: Verstehen, Text Sprache: eng, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Transcript Verlag, Verlag: Transcript Verlag, Verlag: Gost, Roswitha, u. Karin Werner, Länge: 222, Breite: 144, Höhe: 13, Gewicht: 318, Produktform: Kartoniert, Genre: Geisteswissenschaften/Kunst/Musik, Genre: Geisteswissenschaften/Kunst/Musik, Alternatives Format EAN: 9783839454138, Herkunftsland: DEUTSCHLAND (DE), Katalog: Gesamtkatalog, Katalog: Internationale Lagertitel, Katalog: internationale Titel, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 238538324,19 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die beliebtesten Arten von Modding in der Gaming-Community?
Die beliebtesten Arten von Modding in der Gaming-Community sind Texturen- und Grafikmodifikationen, die das Aussehen des Spiels verbessern. Außerdem sind Gameplay-Mods beliebt, die neue Funktionen, Charaktere oder Missionen hinzufügen. Schließlich sind auch Total Conversion Mods beliebt, die das Spiel vollständig verändern und eine neue Spielerfahrung bieten. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Bereichsspezifische Informationsextraktion für semantische Annotation, Taschenbuch von Zeeshan Ahmed, BoD - Books on Demand, 978-620-2-73428-8Bereichsspezifische Informationsextraktion Für Semantische Annotation, Taschenbuch Von Zeeshan Ahmed, Bod - Books On Demand, 978-620-2-73428-8, Seitenanzahl: 8426,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Modell zur Informationsextraktion für Afan Oromo Nachrichtentexte, Taschenbuch von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7Modell Zur Informationsextraktion Für Afan Oromo Nachrichtentexte, Taschenbuch Von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7, Seitenanzahl: 6849,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
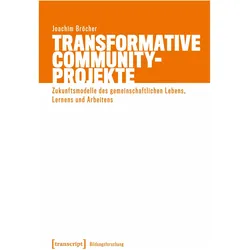
Transformative Community-Projekte, Fachbücher von Joachim BröcherDas Buch "Transformative Community-Projekte" von Joachim Bröcher bietet einen tiefen Einblick in innovative Ansätze zur Gestaltung gemeinschaftlichen Lebens, Lernens und Arbeitens. Anhand eines konkreten Beispiels, dem Dreiseitenhof in Ostdeutschland, wird ein Prototyp eines transformativen Community-Projekts vorgestellt, das als sozialutopisches Labor fungiert. Hier kommen Menschen unterschiedlichen Alters zusammen, um Verantwortung zu übernehmen und einen stabilen sozialen Zusammenhalt zu fördern. Die Prinzipien des Projekts beinhalten gemeinschaftliche Nutzung von Ressourcen, Entrepreneurship, Teilzeitarbeit und Entschleunigung. Bröcher diskutiert auch die politischen Rahmenbedingungen, die für die Umsetzung solcher Zukunftsmodelle notwendig sind, wie direkte Demokratie und bedingungsloses Grundeinkommen. Dieses Fachbuch richtet sich an alle, die sich für soziale Innovationen und die Zukunft des gemeinschaftlichen Lebens interessieren.39,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.